L’essentiel
- En podcast, la voix n’est pas un élément du mixage : elle est le mixage. Tout le reste est décor.
- La distance au micro et l’acoustique de la pièce décident du résultat avant le moindre plugin.
- Une piste par intervenant, jamais un mélange enregistré : sans cela, aucune homogénéisation n’est possible au montage.
- Cible de livraison : -16 LUFS en stéréo, environ -19 LUFS en mono, avec un plafond de crête vraie à -1 dBTP.
Un podcast n’a ni image, ni décor, ni montage rythmique pour rattraper une voix médiocre. L’auditeur écoute dans un casque à écouteurs à trente euros, dans une voiture, ou dans une cuisine avec la hotte allumée, et il décide en une trentaine de secondes s’il reste. Ce qui se joue dans ces trente secondes n’est pas le sujet de l’épisode : c’est le confort d’écoute.
La bonne nouvelle, c’est qu’une production parlée est techniquement simple. Il n’y a ni instrument, ni spatialisation complexe, ni arbitrage entre vingt sources. La contrepartie, c’est qu’aucun défaut ne se cache : un souffle, une pièce trop vivante, un invité deux fois plus fort que l’hôte, et le problème occupe toute la place. Voici la chaîne complète, de la position du micro à l’export.
Tout commence par la distance au micro
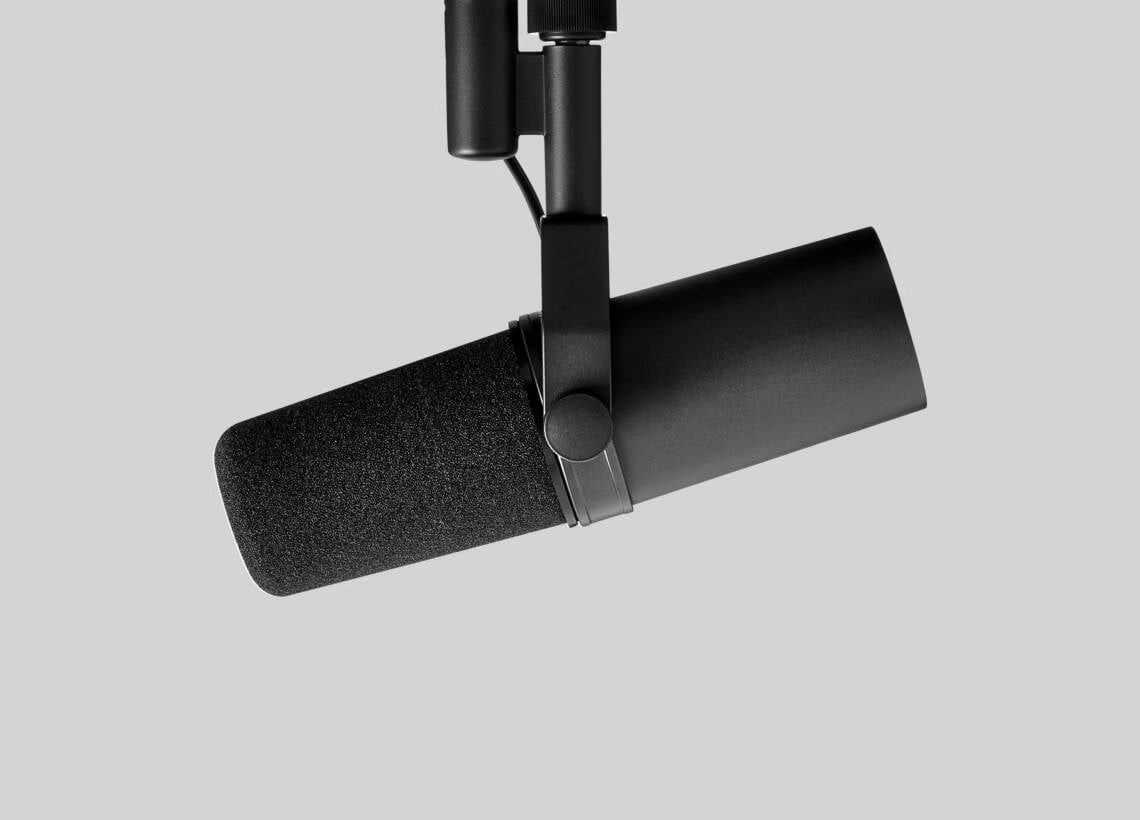
Le débat statique contre dynamique occupe beaucoup de place dans les discussions de podcasteurs, et il est largement secondaire. Ce qui décide du résultat, c’est le rapport entre le son direct et le son de la pièce, et ce rapport dépend d’abord de la distance.
À 40 cm d’un micro, dans une pièce ordinaire, la part de réverbération devient audible et gênante. À 10 ou 15 cm, elle passe au second plan. Cette seule différence pèse plus lourd que le choix de la capsule. Elle explique aussi pourquoi un micro dynamique cardioïde, moins sensible et travaillant en proximité, donne souvent un meilleur résultat en pièce non traitée qu’un statique large membrane de qualité supérieure : il entend moins la pièce parce qu’on parle plus près.
Trois règles pratiques en découlent. On se place à une largeur de poing de la grille, légèrement hors axe pour que les plosives passent à côté plutôt que dedans. On ajoute un filtre anti-pop, qui sert autant à fixer la distance qu’à filtrer les « p ». Et on suspend le micro sur un bras plutôt que de le poser sur le bureau, faute de quoi chaque frappe de clavier et chaque déplacement de tasse remonte par la structure.
La pièce pèse plus lourd que le micro
Un studio de podcast n’a pas besoin d’être beau, il a besoin d’être mat. La priorité absolue est le mur situé derrière l’orateur, car c’est lui qui renvoie le son de la voix directement dans le dos du micro. Vient ensuite le mur d’en face, puis le plateau lui-même, qui produit une réflexion très courte, responsable de cette coloration en peigne qui rend une voix « creuse » sans qu’on sache pourquoi.
Deux panneaux absorbants de 60 par 120 cm, épaisseur 10 cm, bien placés, transforment une pièce ordinaire. Un tapis, des rideaux lourds et une bibliothèque garnie font une partie du travail à moindre coût. Ce qui ne fonctionne pas, en revanche, ce sont les mousses alvéolées fines collées au hasard : elles absorbent l’aigu et laissent le bas médium intact, ce qui produit une pièce sourde et toujours boueuse. Les principes d’absorption, de diffusion et de traitement des modes sont détaillés dans notre guide du traitement acoustique.
Une piste par intervenant, toujours
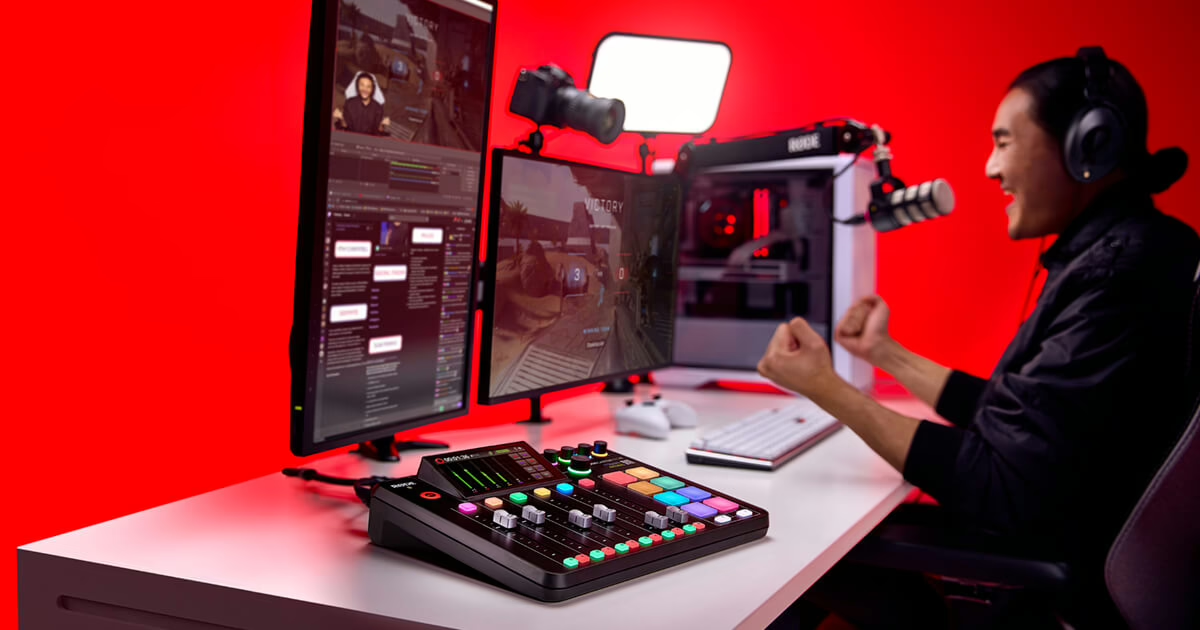
C’est la décision qui conditionne toute la suite. Enregistrer un mélange stéréo de la conversation économise trois clics et interdit définitivement de corriger quoi que ce soit : plus moyen de rattraper l’invité qui parle trop loin, de supprimer la reprise du micro voisin, ni d’homogénéiser les niveaux. Toutes les consoles de podcast actuelles enregistrent en multipiste sur carte SD ou par USB, et il faut utiliser cette possibilité systématiquement.
Le cas des invités à distance mérite un traitement à part. Un flux de visioconférence est compressé, tronqué en bande passante et soumis aux aléas du réseau : il ne constitue pas une matière exploitable pour une production soignée. La solution consiste à faire enregistrer localement chaque participant, sur son propre appareil, et à ne se servir du flux temps réel que comme référence de synchronisation. Le retour envoyé à cet invité doit être un mix-minus, c’est-à-dire tout le programme sauf sa propre voix, faute de quoi il s’entend en écho et finit par ne plus parler normalement. Le principe et son câblage sont expliqués dans notre article sur le mix-minus.
Monter avant de mixer
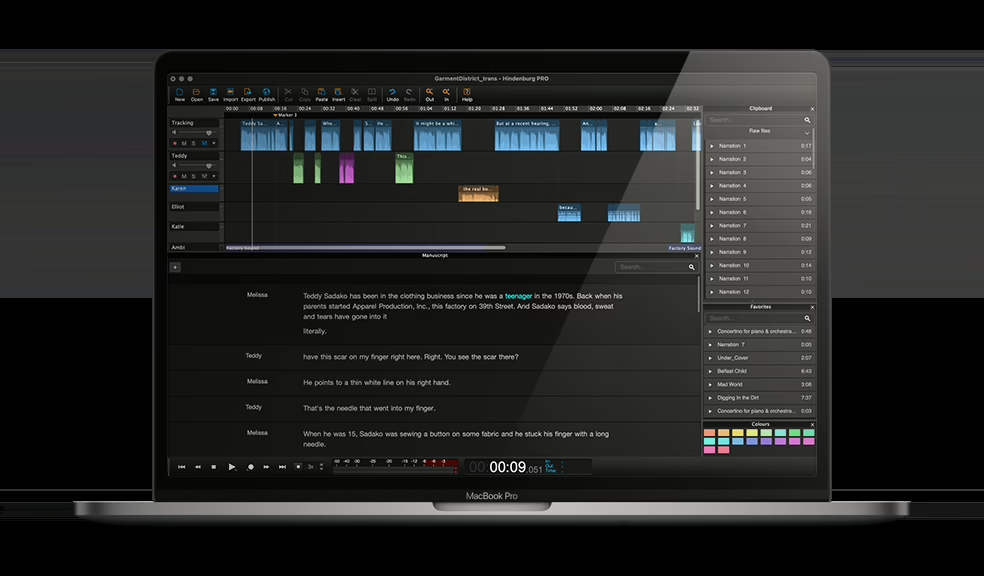
Le montage d’un programme parlé n’est pas un travail de mixeur, c’est un travail d’éditeur. Il consiste à retirer les hésitations, les redites, les faux départs et les silences trop longs, et à recoller le tout de manière inaudible. Les stations orientées voix organisent leur interface autour de cette tâche, avec un traitement automatique du niveau par région et des coupes qui préservent la continuité de l’ambiance.
Trois écueils reviennent. Le premier consiste à supprimer tous les silences : un dialogue sans respiration devient étouffant à l’écoute et illisible sur la durée. Il faut retirer les temps morts, pas la ponctuation. Le deuxième consiste à couper au milieu d’une respiration, ce qui produit un artefact que l’oreille repère immédiatement — on coupe au silence, ou on croise sur quelques millisecondes. Le troisième consiste à monter en regardant la forme d’onde plutôt qu’en écoutant : un blanc de 400 ms peut être parfaitement naturel ou franchement gênant selon ce qui le précède.
Sur les prises multi-micros faites dans la même pièce, la diaphonie est le vrai sujet. Chaque micro capte aussi les autres intervenants, avec un léger retard et un timbre dégradé. Couper les pistes en dehors des interventions — à la main, ou avec un expandeur doux — resserre immédiatement l’image sonore et supprime la sensation de pièce qui monte dès que plusieurs micros sont ouverts.
La chaîne de traitement, adaptée à la voix parlée
La séquence est la même que pour un montage vidéo — nettoyage, coupe-bas, égalisation soustractive, compression, de-essing, calibrage — et nous l’avons détaillée étage par étage dans notre article sur la chaîne de traitement de la voix en montage vidéo. Trois particularités méritent cependant d’être soulignées en podcast.
D’abord, la compression peut être plus franche qu’en fiction ou en documentaire. Un podcast s’écoute majoritairement en mobilité, dans des environnements bruyants, sur des transducteurs médiocres. Une dynamique résiduelle de 8 à 10 dB entre le plus fort et le plus faible convient ; au-delà, l’auditeur passe son temps sur le bouton de volume. Deux étages de 4 à 5 dB chacun restent préférables à un seul réglé fort.
Ensuite, le traitement se fait piste par piste avant tout traitement de bus. Chaque voix a sa fondamentale, sa zone de sifflantes et sa dynamique propre : un réglage unique appliqué sur le mélange fonctionne pour un intervenant et abîme l’autre. Le bus master ne porte qu’un limiteur transparent et le calibrage final.
Enfin, le nettoyage doit rester léger. Un podcast enregistré dans une pièce correcte n’a pas besoin d’un isolateur neuronal poussé à fond ; il a besoin de 4 à 6 dB de réduction de bruit et d’un coupe-bas bien réglé. Les outils de séparation de voix, dont nous avons dressé le panorama complet, sont à réserver aux prises réellement compromises.
| Réglage | Voix grave | Voix médium | Voix claire |
|---|---|---|---|
| Coupe-bas | 70 à 80 Hz | 85 à 100 Hz | 100 à 120 Hz |
| Creux de bas médium | 250 Hz, -3 dB | 300 Hz, -2 dB | 350 Hz, -2 dB |
| Relevé de présence | 3,5 kHz, +2 dB | 3 kHz, +2 dB | 2,5 kHz, +1,5 dB |
| Bande du de-esser | 5 à 7 kHz | 6 à 8 kHz | 6,5 à 9 kHz |
| Réduction totale en compression | 7 à 9 dB | 7 à 9 dB | 6 à 8 dB |
Homogénéiser les intervenants sans les uniformiser
L’écart de niveau entre un hôte habitué au micro et un invité qui parle dans le vide est le défaut le plus fréquent des podcasts d’entretien, et le plus facile à corriger. L’objectif n’est pas de faire sonner tout le monde pareil — les timbres doivent rester distincts, c’est ce qui permet de suivre une conversation à trois — mais d’obtenir des niveaux perçus équivalents.
La méthode est mécanique. On isole les interventions de chaque participant, on mesure le niveau intégré de chacune séparément, et on ajuste le gain de la piste pour ramener tout le monde à moins d’une unité d’écart. Ce travail se fait avant la compression, pas après : un compresseur alimenté par des sources de niveaux très différents produit des taux de réduction incomparables d’une piste à l’autre, et l’écart réapparaît sous une autre forme.
Calibrer et exporter
La cible de référence pour une livraison podcast est -16 LUFS en stéréo, avec un plafond de crête vraie à -1 dBTP. Lorsque le programme est distribué en mono, le repère équivalent se situe autour de -19 LUFS, la différence tenant à la façon dont le niveau est intégré sur un seul canal. Les principales plateformes appliquent une normalisation à la lecture : livrer plus fort n’apporte donc aucun avantage et coûte de la dynamique.
La question mono ou stéréo se tranche vite. Un podcast d’entretien enregistré au micro fixe est un programme mono : le livrer en stéréo double le débit sans rien apporter, et complique la vie des lecteurs qui somment les canaux. Le stéréo se justifie quand il y a un habillage musical travaillé, des ambiances, ou une intention de mise en espace. Dans le doute, le mono est le bon choix, et il reste parfaitement compatible avec toutes les plateformes.
Côté format, un MP3 à 128 kbps en mono ou 192 kbps en stéréo reste le compromis le plus sûr en matière de compatibilité. Le plafond à -1 dBTP prend ici tout son sens : c’est précisément l’encodage en débit réduit qui fabrique des dépassements sur les crêtes, donc des craquements chez l’auditeur. Le détail de ces mesures est traité dans notre guide du loudness.
Le matériel qui change réellement quelque chose
La hiérarchie des investissements utiles est contre-intuitive. Le traitement acoustique arrive en tête, loin devant tout le reste, parce qu’il corrige le seul défaut qu’aucun logiciel ne rattrape. Vient ensuite le bras de micro et le filtre anti-pop, qui fixent une distance de travail constante. Le micro lui-même n’arrive qu’en troisième position : un dynamique cardioïde de qualité correcte, utilisé en proximité dans une pièce traitée, surclasse un statique haut de gamme placé à cinquante centimètres dans un salon vide.
Les consoles de podcast intégrées ont, elles, un intérêt réel mais rarement celui qu’on leur prête. Leur apport n’est pas sonore : il est organisationnel. Elles fournissent des préamplis à gain élevé adaptés aux micros dynamiques peu sensibles, un enregistrement multipiste sans ordinateur, des retours casque indépendants pour chaque participant et une gestion native du mix-minus pour les intervenants au téléphone. Pour les tournages en extérieur, les systèmes sans fil compacts couvrent désormais le même besoin dans un format de poche, comme le Hollyland MELO P1.
Les erreurs qui coûtent le plus cher
- Enregistrer un mélange au lieu de pistes séparées : aucune correction n’est plus possible.
- Traiter la pièce en dernier, après avoir acheté le micro.
- Utiliser le flux de visioconférence comme matière définitive pour un invité à distance.
- Appliquer un traitement unique sur le bus au lieu de traiter chaque voix séparément.
- Supprimer toutes les respirations et tous les silences au montage.
- Exporter en stéréo un programme intégralement mono, et à un niveau supérieur à la cible.
La démonstration en vidéo
RØDE détaille le fonctionnement des traitements de voix embarqués dans sa console de podcast, un bon aperçu de ce que ces machines automatisent réellement au moment de la prise.
Rien dans cette chaîne ne relève de l’exploit technique. Elle demande surtout de la constance : le même micro, à la même distance, dans la même pièce, avec les mêmes réglages sauvegardés en préréglage et la même cible de niveau à l’export. C’est cette régularité d’un épisode à l’autre, bien plus que la sophistication du traitement, qui fait qu’un podcast s’écoute sans fatigue sur la durée.